1. 論文要解決的核心問題
強化學習智慧體傳統上直接從畫素學策略,存在兩個大問題:
- 樣本效率低——需要和真實環境互動海量次數
- 端到端訓練難以拆解、難以複用
這篇論文提出:先讓智慧體學會”理解世界如何運作”,再基於這個內部理解去做決策,並驗證了一個大膽的推論——如果這個內部理解足夠準,智慧體甚至可以完全在自己的”想像”裡完成訓練,不需要真實環境參與。
2. 三大模組:V / M / C
智慧體被拆成三個獨立訓練的模組,分工明確:
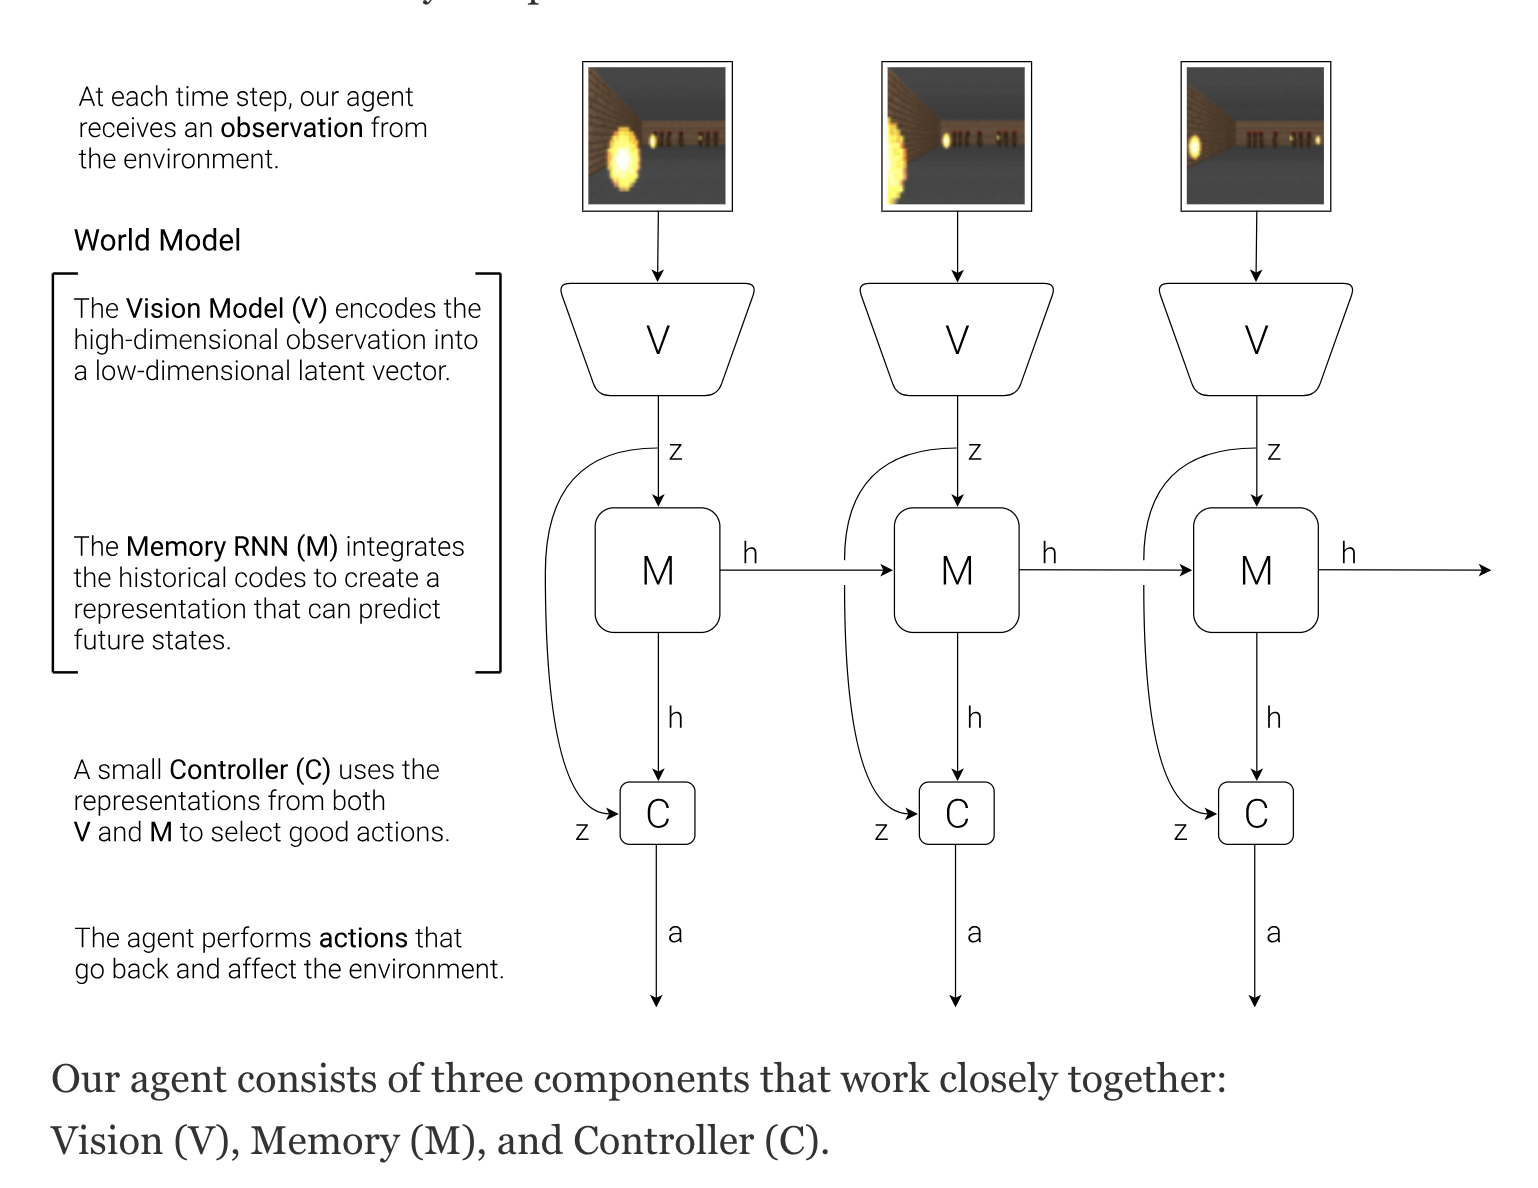
- V(Vision):用 VAE 把每一幀高維影像壓縮成一個低維潛變數 (論文裡 維)
- M(Memory):用 RNN + MDN 學習環境的轉移動態,預測下一時刻的 可能長什麼樣
- C(Controller):一個極簡的線性模型,把 直接對映到動作
動作 的反饋迴路:圖中 C 輸出的 只畫了向下的箭頭(流向”環境”),但這個 同時也會反饋進入下一步的 M——完整的因果鏈條是:
在時間 是 C 的輸出,在時間 就變成了 M 需要的輸入——同一個變數,在因果鏈條上的兩個位置,這是標準的”智慧體-環境互動迴圈”。
3. V 模組:VAE 的原理與訓練
3.1 VAE 結構:Encoder + Decoder,聯合訓練
Encoder 不能單獨訓練——重建損失必須靠 Decoder 才能算出來,訓練訊號(梯度)從 Decoder 端產生,經反向傳播一路傳回 Encoder。如果沒有 Decoder 參與,Encoder 收不到任何”該怎麼編碼才有意義”的反饋,唯一的驅動力(KL項)會讓它退化成對所有輸入都輸出 。
3.2 損失函數:重建項 + KL 正則,兩者都源於同一個數學目標
這兩項不是拼湊出來的,而是從最大化 的證據下界(ELBO)推匯出來的:
- 重建損失:強迫 必須攜帶足夠的關於 的資訊,否則 Decoder 無法還原
- KL 正則:強迫每張圖對應的分佈 不能離先驗 太遠,防止退化、並讓潛空間連續、稠密、無空洞
兩項損失存在天然張力:重建損失想把不同輸入的編碼拉開,KL 項想把所有編碼拉向公共的標準正態——訓練收斂的結果是兩者的折中。
3.3 先驗 是什麼
不是一個向量,而是定義在整個 維潛空間上的一個分佈—— 個相互獨立的標準常態分布拼在一起:
下圖直觀展示了 時,從這個分佈取樣1500個點是什麼樣子——散點雲呈圓形對稱分佈,把每個點單獨投影到某一個座標軸上統計,得到的就是一維的標準正態曲線:
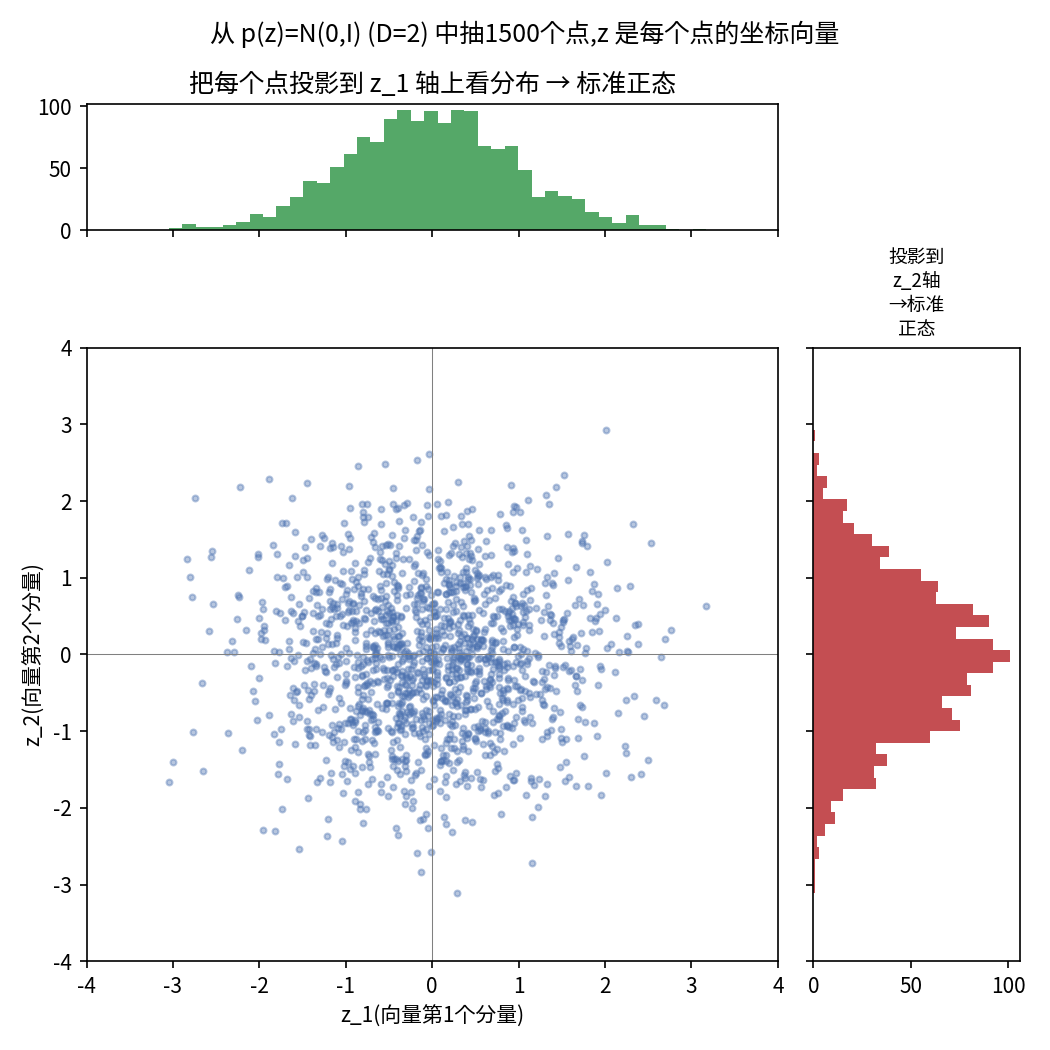
這個先驗分佈本身不攜帶任何預設的語義——它只是一個數學上方便處理的參照系(KL 散度有閉式解、支援重參數化技巧、取樣簡單、各向同性無偏好方向)。真正讓潛空間”有意義”的,是 Encoder 和 Decoder 在訓練中協調學出的對映關係。
3.4 “一張圖對應哪個 z”——對應的是一個區域,不是一個點
Encoder 對每張具體的圖 ,輸出的是這張圖專屬的 ,再從 (而不是原始的通用 )中取樣,得到最終的 :
這個取樣公式,是標準化操作 的逆運算:標準化是把任意常態分布”拉回”標準正態,這裡則是把標準正態樣本 “變換”成指定平均值變異數的分佈——都是在利用常態分布對線性變換封閉這條性質。這一寫法叫重參數化技巧(reparameterization trick),它把不可導的”隨機取樣”操作,轉化成對 可導的線性運算,讓梯度能順利反向傳播。
訓練前後的對比——訓練開始時 Encoder 權重隨機,同類圖片的編碼位置毫無規律;訓練收斂後,相似的圖片被推到潛空間中彼此靠近的區域,整體形狀依然趨近先驗 :
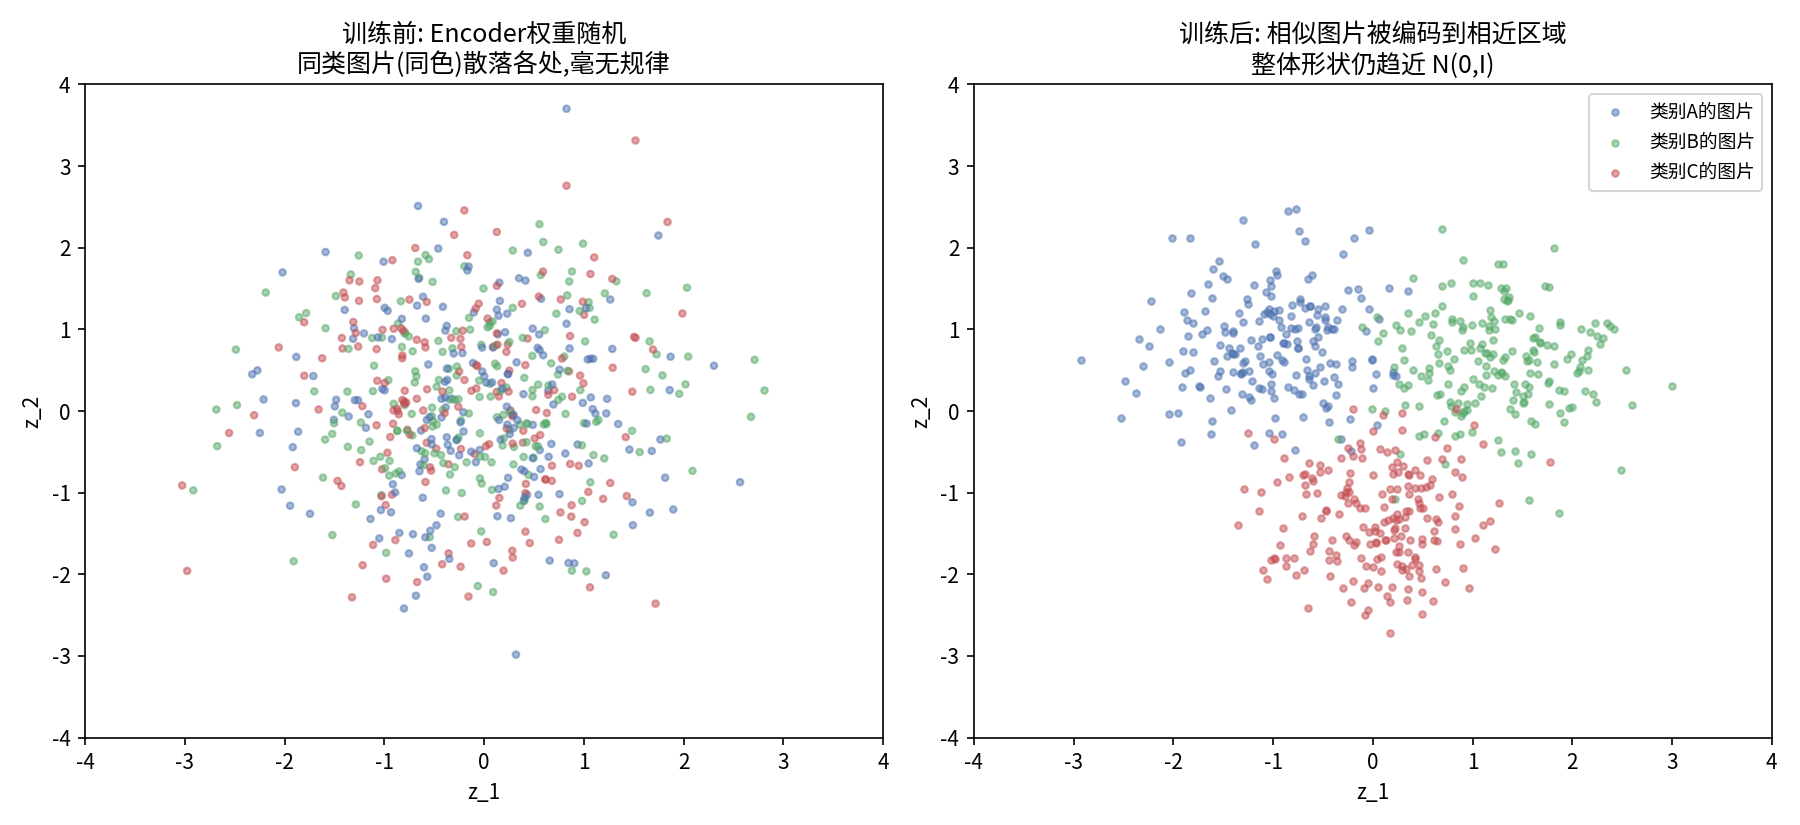
這個”圖 → 區域”的對映關係,不是人為設計或指定的,而是重建損失和 KL 正則兩股力量共同”逼”出來的必然結構——具體每一維代表什麼語義,人類通常無法預先解釋,往往需要事後做探索性分析(如固定其他維度、遍歷某一維觀察解碼結果)才能大致解讀。不同的訓練順序、權重初始化、取樣噪聲,會讓訓練收斂到潛空間的不同”朝向”(比如整個潛空間可以任意旋轉,先驗分佈保持不變),但只要重建質量高、潛空間連續,這些不同版本的 VAE 在功能上是同樣合格的。
3.5 VAE vs 普通 Autoencoder
| Autoencoder | VAE | |
|---|---|---|
| Encoder 輸出 | 一個確定的向量 | 一個分佈的參數 |
| 訓練目標 | 只有重建損失 | 重建損失 + KL 散度 |
| 潛空間結構 | 無約束,可能有空洞 | 連續、稠密,適合取樣 |
| 能否從中取樣生成新內容 | 不行(容易亂碼) | 可以 |
4. M 模組:RNN + MDN
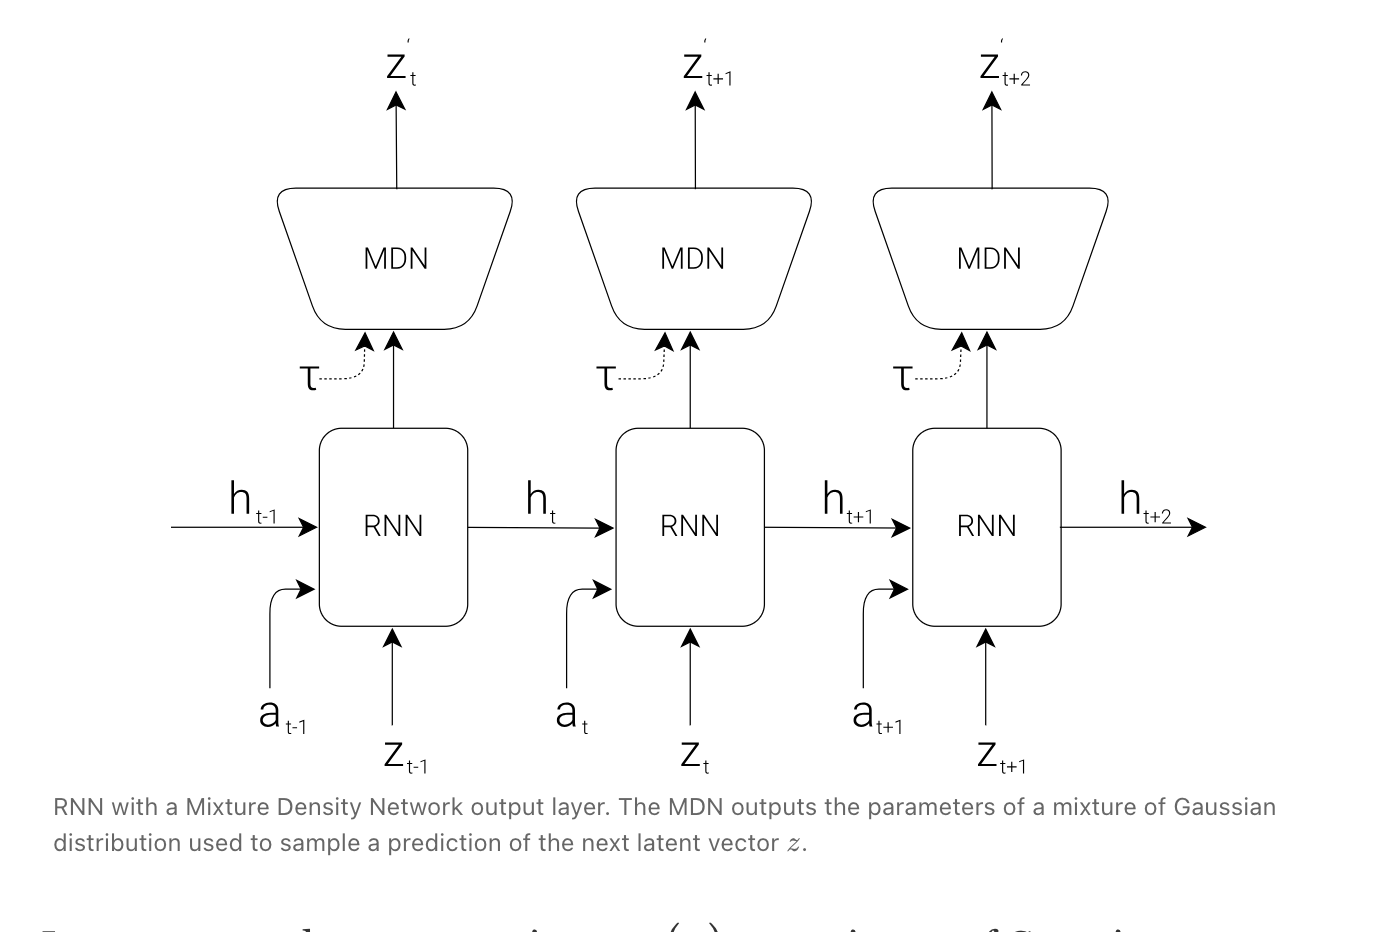
RNN 每一步吃進 ,更新出隱藏狀態 :
4.1 為什麼用 MDN 而不是直接回歸
環境的未來往往是多模態的(同一段歷史可能對應好幾種合理但截然不同的走向)。若直接回歸輸出一個 ,MSE 訓練會讓網路學出”模糊的平均值”,誰都不像。MDN 讓網路輸出一個混合高斯分佈的參數:
| 參數 | 數量 | 含義 | 約束 |
|---|---|---|---|
| 個 | 選中每個分量的機率,所有維度共享同一套 | softmax,非負且和為1 | |
| 個 | 每個分量下, 每一維的期望值 | 無約束 | |
| 個 | 每個分量下, 每一維的離散程度 | 需為正 |
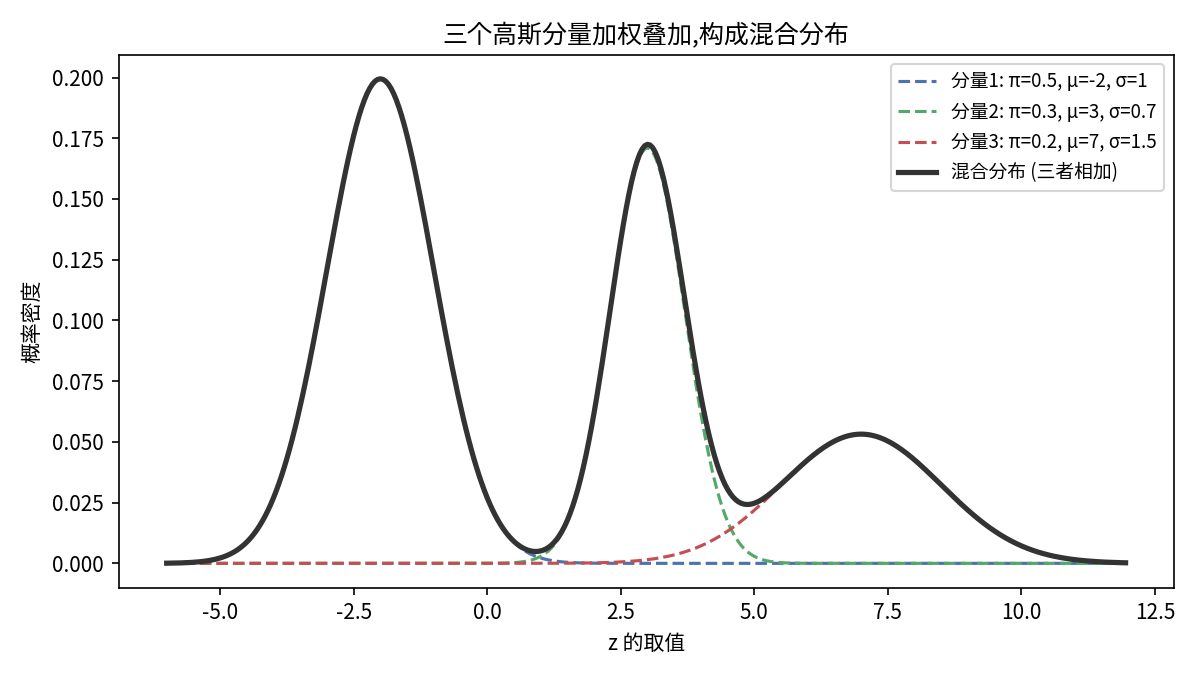
下圖展示了三個高斯分量按權重疊加成混合分佈的直覺:
4.2 取樣:兩步走
先按 抽籤選一個分量(整個 維向量只抽一次),再在選中的分量下,每一維獨立取樣——不是把各分量加權平均。 只負責”選擇”這一步,選定之後就不再參與計算,這正是 MDN 能表達多模態、而不退化成模糊平均的關鍵。
4.3 訓練:Teacher Forcing
訓練時,RNN 每一步的輸入始終是真實的 (來自 V 編碼真實觀測),而不是模型自己取樣出的 ,損失函數是負對數似然:
這一階段 MDN 取樣出的 只用來算一次損失就被丟棄,不參與後續前向傳播——訓練全程錨定在真實資料上,不存在自迴歸誤差累積的問題。
4.4 推理:MDN 輸出分佈,如何落地成一個具體向量
推理時不直接”處理”密度值,而是執行標準的取樣流程,最終得到一個確定性的向量:
pi = softmax(pi_logits / tau)          # tau: 温度参数,控制随机程度
sigma = exp(log_sigma) * sqrt(tau)
k = multinomial(pi, num_samples=1)     # 第一步: 选分量
epsilon = randn_like(mu[k])
z_next = mu[k] + sigma[k] * epsilon    # 第二步: 采样得到具体向量
溫度參數 : 趨向於”總是選權重最大的分量、幾乎不加噪聲”(類似 LLM 裡的貪心解碼); 越大隨機性越強。做夢階段若 太低,生成的虛擬環境過於規整,Controller 容易”鑽空子”而非學到魯棒策略。
與 LLM 的類比:MDN 和 LLM 的下一詞預測本質上是同一類問題——都是”網路輸出一個分佈的參數,推理時按機率取樣得到具體輸出,用溫度控制隨機程度”。區別只在於 LLM 面對有限詞表上的離散選擇(Categorical + softmax),MDN 面對連續實數空間(混合高斯);兩者訓練時都直接用真實標籤算損失(交叉熵 / 負對數似然),不依賴模型自己的取樣結果。
5. 完整訓練流程:三個模組分開訓練,順序進行
| 階段 | 訓練物件 | 資料來源 | 的角色 | 最佳化方法 |
|---|---|---|---|---|
| 1 | V(VAE) | 隨機策略採集的真實幀 | 編碼目標 | 重建損失 + KL(梯度下降) |
| 2 | M(RNN+MDN) | V 編碼出的真實 序列 | 輸入用真實 ,teacher forcing | 負對數似然(梯度下降) |
| 3 | C(線性控制器) | M 生成的虛擬軌跡(“做夢”) | 自迴歸取樣的 驅動整條軌跡 | CMA-ES(進化策略) |
做夢階段的核心迴圈:
C 參數量極小(幾百個,線性模型),用 CMA-ES 而非梯度類強化學習方法訓練:維護一個參數分佈,每代取樣候選控制器、評估其累積獎勵、據表現更新分佈平均值和共變異數,逐代進化。訓好後把 C 放回真實環境測試,依然表現良好——證明智慧體可以完全脫離真實環境,只靠內部想像完成學習。這裡”評估累積獎勵”具體怎麼算,以及訓練究竟是在真實環境還是夢境裡進行,詳見第六節。
6. Action 與 Reward 是從哪裡來的
這是讓整套訓練流程能跑通的兩個容易被忽略、但缺一不可的細節。
6.1 訓練 V、M 階段:action 由隨機策略生成
採集資料訓練 V 和 M 時,論文用完全隨機的策略去探索環境——不需要任何智慧,每一步直接從動作空間裡隨機取樣:
- CarRacing(連續動作):轉向、加速、剎車三個連續值,每步隨機取樣
- VizDoom(離散動作):從有限幾個動作選項裡隨機選一個
這一階段的目標只是讓 V、M 見識到足夠多樣的畫面和狀態轉移,不需要”表現聰明”。社群復現時發現純粹逐幀獨立的白噪聲動作會讓賽車很快衝出賽道、探索範圍太窄,因此常改用帶時間相關性(“布朗運動式”)的隨機策略,讓動作在時間上平滑漂移,以採集到更連貫、更有代表性的軌跡。
6.2 訓練 C 階段:reward 的來源,因實驗而異
CarRacing:C 的訓練直接在真實環境裡進行,reward 就是 Gym 環境自帶的獎勵函數(訪問的賽道格子數、用時),不涉及”夢境裡怎麼算獎勵”的問題。
VizDoom(真正”完全在夢境裡訓練”的實驗):該環境本身沒有顯式獎勵,論文把獎勵重新定義為存活的時間步數。為了讓這個定義能在夢境裡同樣成立,M 模組被擴充為額外預測一個”done”(是否死亡)訊號,與預測 的分佈並列輸出:
做夢時,一旦這個訊號判定”死亡”,虛擬軌跡終止——軌跡走了多少步,就是這次評估的累積獎勵,不需要額外訓練一個”reward數值預測頭”,巧妙地繞開了”如何在夢境裡憑空生成獎勵數值”這個問題。
對於獎勵結構更復雜(不只是”死沒死”)的環境,更通用的做法(後續 PlaNet、Dreamer 採用)是再給 M 加一個獎勵預測頭,和預測 、predict done 並列,用真實環境觀測到的 reward 做監督訓練,做夢時每一步直接輸出一個預測的 reward 數值、累加得到總獎勵。
| 實驗 | C 在哪訓練 | reward 來源 |
|---|---|---|
| CarRacing | 真實環境 | 環境自帶獎勵函數,直接讀取 |
| VizDoom(做夢實驗) | 完全在 M 生成的虛擬環境裡 | 獎勵=存活步數,由 M 額外預測的”done”訊號間接決定 |
7. 為什麼這篇論文重要
它把”感知壓縮、動態預測、決策”三件事解耦成三個獨立訓練的小模組,大幅降低了訓練難度和參數量;更重要的是,它第一次具體地證明了”在想像中訓練”這件事是可行的。
這條思路直接啟發了後續 DeepMind 的 PlaNet、Dreamer 系列(把”做夢訓練”發展得更徹底,完全在潛空間裡做多步展開,連解碼回畫素這一步都可以省略),也是這幾年”世界模型”重新成為大模型/生成式建模熱點話題(如 Sora、Genie、JEPA 等)的重要源頭之一。